کاربرد هوش مصنوعی در تشخیص بیماریها: راهنمای جامع و عملی برای پژوهشگران
فهرست مطالب
- انتخاب مدل هوش مصنوعی باید دقیقاً با نوع داده پزشکی (تصویر، سیگنال یا پرونده متنی) متناسب باشد.
- معیار Accuracy در دادههای نامتوازن پزشکی گمراهکننده است؛ تمرکز اصلی باید بر Recall و ROC-AUC باشد.
- بزرگترین مانع پیشبرد پروژهها، عدم رعایت استانداردهای حریم خصوصی (HIPAA/GDPR) و نشست دادهها است.
- صحتسنجی بالینی متقابل (Cross-Validation) روی دادههای خارج از بیمارستان مبدأ برای پذیرش مقاله ضروری است.
اجرای پروژههای پژوهشی در زمینه کاربرد هوش مصنوعی در تشخیص بیماریها اغلب به دلیل عدم دسترسی به دادههای استاندارد، انتخاب اشتباه معیارهای ارزیابی و عدم درک نیازمندیهای بالینی با شکست مواجه میشود. این مقاله یک راهنمای عملی و گامبهگام برای دانشجویان و پژوهشگران علوم داده و پزشکی است تا بتوانند مدلهای خود را از مرحله دادهپروالایی تا پیادهسازی و اخذ تأییدیه علمی به درستی مدیریت کنند.
۱. الگوریتمهای اصلی هوش مصنوعی در تشخیص بیماریها
پاسخ کوتاه: الگوریتمهای مبتنی بر یادگیری عمیق مانند CNNها برای دادههای تصویری (رادیولوژی و پاتولوژی) و مدلهای مبتنی بر ترنسفورمر (NLP) برای تحلیل پروندههای الکترونیک سلامت (EHR)، بیشترین دقت و کاربرد عملی را در تشخیص دقیق بیماریها دارند.
در حوزه پزشکی، مدلهای هوش مصنوعی به سه دسته اصلی تقسیم میشوند. انتخاب مدل بستگی مستقیم به ماهیت دادههای ورودی دارد و اشتباه در این گام، کل خروجی پژوهش را زیر سوال میبرد.
شبکههای عصبی پیچشی (CNN) در پردازش تصویر پزشکی
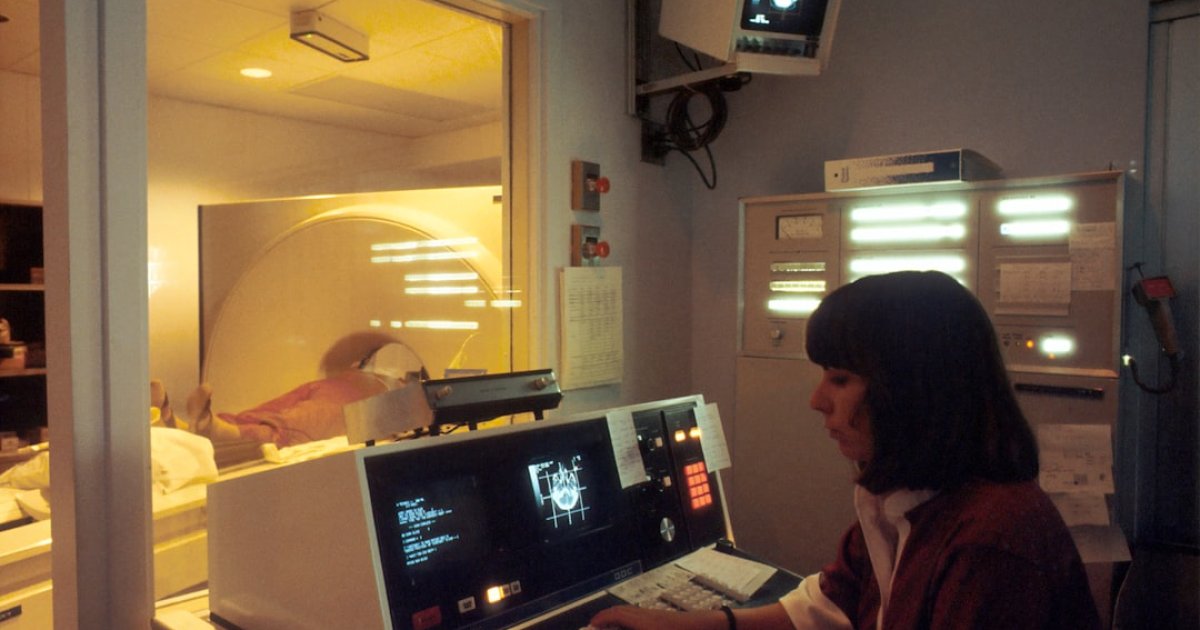
معماریهای مدرن مانند ResNet، EfficientNet و Vision Transformers (ViT) استاندارد طلایی تشخیص آسیبها در تصاویری مانند MRI، CT-Scan و X-Ray هستند. این مدلها ویژگیهای ظریف بافتی را که ممکن است از چشم چشمپزشک یا رادیولوژیست پنهان بماند، شناسایی میکنند.
مدلهای پردازش زبان طبیعی (NLP) در پروندههای سلامت
برای استخراج متغیرها از متون بالینی دستنویس یا تایپشده، مدلهای برپایه BERT (مانند BioBERT و ClinicalBERT) استفاده میشوند. این ابزارها امکان پیشبینی ابتلا به بیماریهای مزمن را از روی سوابق بیمار فراهم میسازند.
۲. نقشه راه ۵ گامه اجرای یک پروژه تشخیص پزشکی
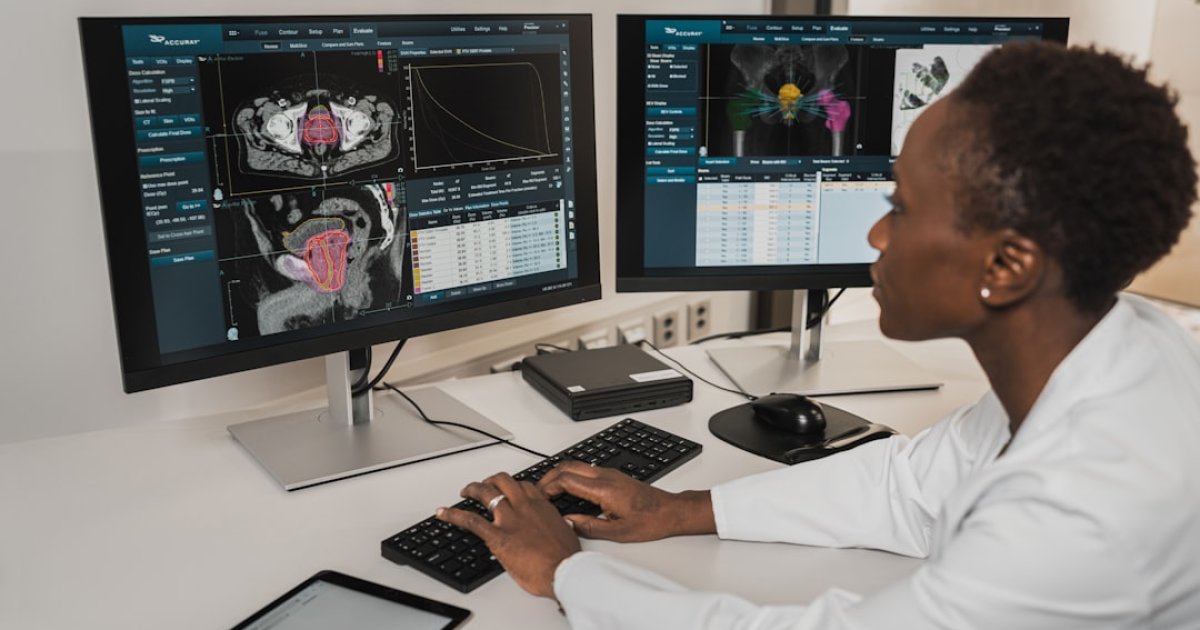
برای طراحی یک سیستم تشخیص هوشمند که قابل ارائه در جوامع علمی و دانشگاهی باشد، باید مسیر زیر به صورت دقیق و متوالی طی شود:
- جمعآوری و بینامسازی دادهها: استفاده از پایگاههای معتبر جهانی مانند MIMIC-III، TCGA یا NIH Chest X-rays و حذف کامل اطلاعات هویتی بیمار.
- پیشپردازش و استانداردسازی: نرمالسازی تصاویر، تغییر مقیاس، و مدیریت دادههای گمشده (Missing Values) در پروندههای پزشکی.
- مدیریت عدم توازن کلاسها (Class Imbalance): استفاده از روشهای SMOTE یا Focal Loss، زیرا در مجموعههای داده واقعی پزشکی، تعداد افراد بیمار بسیار کمتر از افراد سالم است.
- آموزش و تنظیم ابرپارامترها: اعمال تکنیک Transfer Learning به منظور جلوگیری از Overfitting روی دادههای محدود پزشکی.
- ارزیابی بینبیمارستانی (External Validation): تست مدل روی دادههای حاصل از یک مرکز درمانی دیگر برای سنجش میزان تعمیمپذیری.
۳. مقایسه معیارهای ارزیابی مدل در محیطهای بالینی
پاسخ کوتاه: در هوش مصنوعی پزشکی، معیار «حسایت» (Sensitivity/Recall) بالاترین اهمیت را دارد، زیرا منفی کاذب (عدم تشخیص فرد بیمار) خطر مرگبار دارد، در حالی که دقت عمومی (Accuracy) به تنهایی فاقد اعتبار بالینی است.
جدول زیر مهمترین معیارهای ارزیابی الگوریتمهای تشخیص پزشکی را همراه با کاربرد عملی آنها مقایسه میکند:
| معیار ارزیابی | تفسیر و کاربرد بالینی |
|---|---|
| حساسیت (Recall / Sensitivity) | توانایی مدل در شناسایی درست تمام بیماران واقعی. حیاتی برای غربالگری بیماریهای خطرناک مانند سرطان. |
| ویژگی (Specificity) | توانایی تشخیص صحیح افراد سالم. کاهش مثبت کاذب و جلوگیری از استرس و هزینههای درمانی غیرضروری. |
| سطح زیر منحنی (ROC-AUC) | معیار کلی قدرت تفکیک مدل بین حالت بیمار و سالم در آستانههای مختلف. بهترین شاخص ارزیابی مقالهها. |
| امتیاز F1 (F1-Score) | توازن بین دقت (Precision) و فراخوانی (Recall). بسیار مناسب برای مجموعهدادههای نامتوازن پزشکی. |
۴. چالشهای واقعی در پیادهسازی و نفوذ دادهها
پیادهسازی موفق هوش مصنوعی در بیمارستانها فراتر از دستیابی به دقت بالاست. عدم توجه به نکات زیر میتواند مانع از اجرایی شدن پروژه شود:
- مفهوم جعبه سیاه (Black Box): پزشکان به مدلی که علت تصمیمگیری آن مشخص نباشد اعتماد نمیکنند. استفاده از روشهای قابل تفسیر مانند Grad-CAM برای مشخص کردن نواحی درگیر در تصویر الزامی است.
- تغییرات دامنه (Domain Shift): مدلی که روی دستگاه MRI یک بیمارستان آموزش دیده، ممکن است روی تصاویر بیمارستان دیگر عملکرد ضعیفی نشان دهد.
- مسائل اخلاقی و حریم خصوصی: هرگونه نشت اطلاعات بیمار (Data Leakage) موجب بطلان پژوهش و عواقب حقوقی خواهد شد.
۵. اشتباهات رایج پژوهشگران و راهحل سریع
خطای ۱: گزارش تنها دقت کلی (Accuracy) روی دادههای غیرهمگن
راهحل سریع: اگر ۹۵٪ افراد داده سالم هستند، مدل با گفتن “همه سالمند” به دقت ۹۵٪ میرسد! همیشه معیارهای Recall، Precision و F1-Score را جداگانه گزارش کنید.
خطای ۲: نشت داده (Data Leakage) در طول پیشپردازش
راهحل سریع: تمام عملیاتهای نرمالسازی و اعمال تغییرات باید حتماً «پس از» تقسیم دادهها به دو بخش Train و Test انجام شوند.
خطای ۳: عدم استفاده از Cross-Validation گروهبندیشده (GroupKFold)
راهحل سریع: اگر از یک بیمار چند تصویر دارید، تمام تصاویر آن بیمار باید فقط در دسته آموزش یا فقط در دسته تست قرار گیرند تا مدل دچار حفظکردن نشود.
۶. پرسشهای متداول
سوال ۱: بهترین دیتابیسهای رایگان برای شروع پروژه هوش مصنوعی در تشخیص بیماری چیست؟
پایگاههای داده MIMIC-III (برای دادههای بالینی)، Kaggle (برای دیتاستهای تصویربرداری ساده مانند پنومونی)، NIH Chest X-ray و ISIC (برای سرطان پوست) بهترین گزینهها هستند.
سوال ۲: آیا برای مقاله دادن در این حوزه نیاز به تأییدیه اخلاق پزشکی (IRB) داریم؟
اگر از دادههای عمومی بینامسازیشده استفاده کنید نیازی نیست، اما اگر دادهها را مستقیماً از یک بیمارستان داخلی جمعآوری کردهاید، دریافت کد اخلاق الزامی است.
سوال ۳: چه فریمورکی برای شروع پیادهسازی پیشنهاد میشود؟
کتابخانه PyTorch به همراه کتابخانه MONAI (که اختصاصاً برای تصویربرداری پزشکی توسعه یافته) استانداردترین ابزار فعلی پژوهشگران است.
سوال ۴: چطور عدم تمایل پزشکان به استفاده از مدل را در مقاله حل کنیم؟
با اضافه کردن الگوریتمهای هوش مصنوعی قابل تفسیر (Explainable AI) مثل SHAP یا Grad-CAM نشان دهید مدل بر اساس چه معیارهای بالینی تصمیم گرفته است.
نیازمند مشاوره تخصصی در پیادهسازی پروژههای پردازش دادههای پزشکی هستید؟
جهت دریافت مشاوره برای تعریف پروژههای پژوهشی، انتخاب الگوریتم و رفع چالشهای مدلسازی با ما در تماس باشید.