انجام فصل چهارم پایان نامه
- فصل چهارم پایان نامه چیست و چرا قلب رساله است؟
- مراحل گامبهگام نگارش و تحلیل دادهها در فصل ۴
- مقایسه ساختار فصل چهارم در پژوهشهای کمی، کیفی و مهندسی
- کدام نرمافزار آماری یا تحلیلی برای کار شما مناسب است؟
- سه اشتباه مهلک که باعث رد شدن فصل چهارم میشود
- پیوند دادن فصل چهارم با اهداف و پروپوزال
- عیبیابی سریع: پاسخ به مشکلات رایج دانشجویان
فصل چهارم پایان نامه بخش ارایه یافتهها و تحلیل آماری یا کُدگذاری دادهها است. برای موفقیت در این فصل، باید از کپیکردن خروجی خام نرمافزارها پرهیز کنید، جدولها را طبق استاندارد (مانند APA) تنظیم کرده و مستقیماً به سراغ پاسخ به فرضیات بروید. تایید نشدن یک فرضیه به معنی شکست پژوهش نیست، بلکه نحوه تحلیل علمی آن اهمیت دارد.
فصل چهارم پایان نامه، هسته اصلی پژوهش شماست که در آن دادههای خام گردآوریشده از پرسشنامه، مصاحبه، آزمایشگاه یا شبیهسازی به اطلاعات علمی و معنادار تبدیل میشوند. کیفیت این فصل نشاندهنده عیار پژوهشی دانشجو است و داوران در جلسه دفاع بیشترین وقت خود را صرف بررسی دقیق جدولها، نمودارها و تستهای آماری این بخش میکنند. اگر این گام را با دقت و رعایت اصول تحلیلی بردارید، نگارش فصل پنجم و استخراج مقاله از تز بسیار ساده خواهد بود.
فصل چهارم پایان نامه چیست و چرا قلب رساله است؟
پس از آنکه در فصل سوم روش تحقیق خود را مشخص کردید، در فصل چهارم باید همان ابزارها را به کار ببندید. این فصل جایی برای بیان نظر شخصی، مقدمهچینیهای طولانی یا مرور ادبیات نیست؛ بلکه صرفاً گزارش دقیق و بدون جهتگیری از آن چیزی است که دادهها نشان میدهند. اگر در انتخاب روشهای آماری سردرگم هستید، مشورت با یک موسسه انجام پایان نامه معتبر میتواند مسیر تحلیل شما را هموارتر کند و از دوبارهکاریهای زمانبر جلوگیری نماید.
مراحل گامبهگام نگارش و تحلیل دادهها در فصل ۴
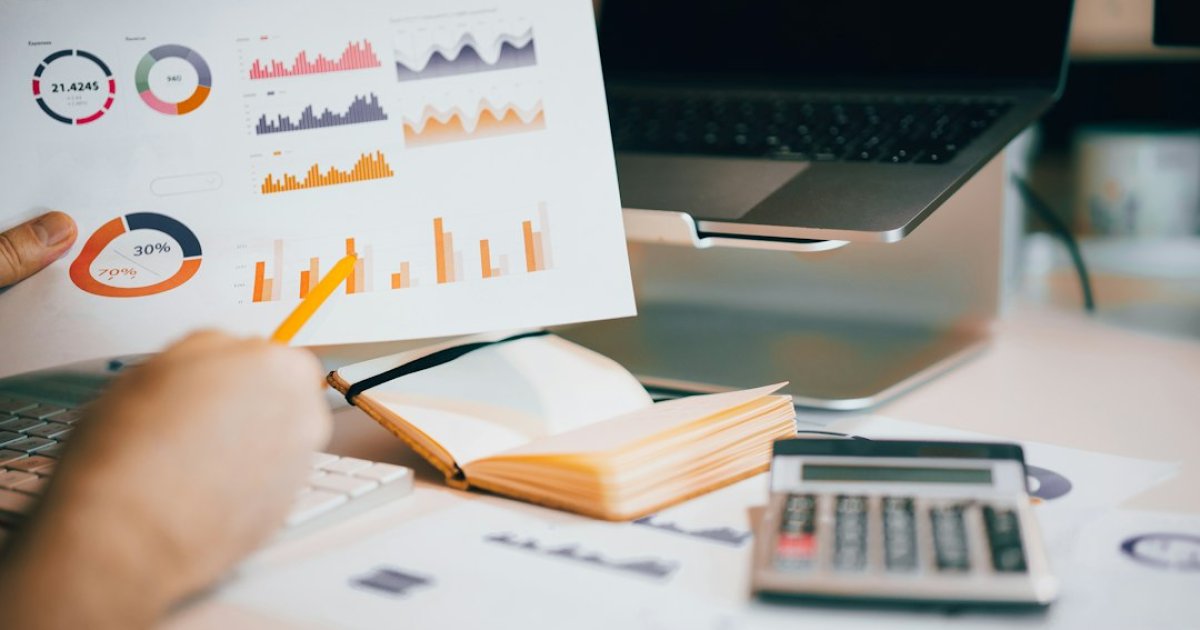
نگارش منظم این فصل باعث میشود داور به سرعت منطق تحلیلی شما را درک کند. استانداردهای دانشگاهی ایجاب میکند که مسیر زیر را به ترتیب طی کنیم:
- پالایش و آمادهسازی دادهها (Data Cleaning): قبل از هر کاری باید دادههای پرت، پرسشنامههای ناقص یا خطاهای ورود داده را شناسایی و حذف کنید.
- توصیف آمار توصیفی: مشخصات دموغرافیک نمونه (سن، جنسیت، تحصیلات و…) را همراه با شاخصهای مرکزی و پراکندگی (میانگین، انحراف معیار) در قالب جدول و نمودار ارائه میدهیم.
- بررسی مفروضات آزمونهای آماری: پیش از اجرای آزمون اصلی، باید پیشفرضهایی مثل نرمال بودن دادهها (آزمون کلموگروف-اسمیرنوف)، همگن بودن واریانسها یا عدم همخطی را بررسی کنید.
- تحلیل آمار استنباطی و آزمون فرضیات: در این بخش با استفاده از آزمونهای متناسب (مثل T-Test، آنوا، رگرسیون یا مدلسازی معادلات ساختاری) به بررسی تکتک فرضیهها میپردازیم.
- خلاصه یافتهها: در انتهای فصل، یک جدول کلی از وضعیت قبول یا رد فرضیات ارائه میشود تا خواننده تصویر روشنی داشته باشد.
البته ناگفته نماند که استاد راهنمای خود من زمان دفاع روی همین بخش اول نمودارها خیلی حساس بود و میگفت نباید نمودارهای میلهای ساده را بدون هیچ توضیحی رها کرد! دادهها را جمعآوری کردیم و سپس جدولها را تحلیل میکنید تا روندها کاملا مشخص شوند.
مقایسه ساختار فصل چهارم در پژوهشهای کمی، کیفی و مهندسی
ساختار فصل ۴ بر اساس رشته و ماهیت تحقیق تفاوتهای اساسی دارد. در پروژههای علوم انسانی بهویژه هنگام انجام پایاننامه روانشناسی بالینی و عمومی، تمرکز اصلی بر آزمونهای همبستگی، تحلیل مسیر و رگرسیون است. در مقابل، پروژههای فنی مانند انجام پایان نامه مهندسی مکانیک عمدتاً بر پایه شبیهسازی عددی، تحلیل المان محدود و صحتسنجی (Validation) با دادههای تجربی پیش میروند.
| نوع پژوهش | عناصر اصلی فصل چهارم |
|---|---|
| کمی (پرسشنامهای / پیمایشی) | آمار توصیفی، آزمون نرمالیته، تحلیل عاملی، مدلسازی معادلات ساختاری (SEM)، تست فرضیات. |
| کیفی (مصاحبه / تحلیل مضمون) | کدگذاری باز، محوری و انتخابی، شبکه مضامین (Theme Network)، استخراج مقولههای اصلی و شبکهسازی مفاهیم. |
| مکانیکی و شبیهسازی (فنی) | نتایج حل عددی، شبکه استقلال از مش، استخراج کانتورها، اعتبار سنجی (Validation) با کارهای آزمایشگاهی. |
کدام نرمافزار آماری یا تحلیلی برای کار شما مناسب است؟
انتخاب ابزار اشتباه میتواند کل زحمات شما را هدر دهد. نرمافزار باید بر اساس نوع دادهها و پیچیدگی فرضیات انتخاب شود:
- SPSS: رایجترین نرم افزار برای تحلیلی های آمار توصیفی، آزمونهای T، آنوا و رگرسیون خطی ساده در علوم انسانی.
- SmartPLS و AMOS: مخصوص مدلسازی معادلات ساختاری. اگر حجم نمونه شما کم است، SmartPLS انتخاب بسیار بهتری نسبت به AMOS است.
- MAXQDA و NVivo: بهترین ابزارها برای کدگذاری متن مصاحبهها در پژوهشهای کیفی و تحلیل تم.
- Python و R: مناسب برای دادههای حجیم (Big Data)، یادگیری ماشین و تحلیلهای پیشرفته آماری که نیاز به کدنویسی دقیق دارند.
سه اشتباه مهلک که باعث رد شدن فصل چهارم میشود
بسیاری از دانشجویان به دلیل عدم اطلاع از اصول نگارش آکادمیک، دچار خطاهایی میشوند که اصلاح آنها هفتهها زمان میبرد:
۱. کپیپیست کردن خروجی خام نرمافزار
داوران به شدت با دیدن جدولهای انگلیسی خروجی SPSS یا PLS با پسزمینه خاکستری یا فونتهای نامناسب واکنش منفی نشان میدهند. تمام جدولها باید بازنویسی شده، به زبان فارسی ترجمه و طبق استاندارد دانشگاه (معمولاً فونت B Nazanin یا B Zar) تنظیم گردند.
۲. عدم تحلیل و بسندهکردن به گزارش اعداد
گفتن اینکه «مقدار p-value برابر ۰.۰۳ شد پس فرضیه تایید است» کافی نیست! شما باید شرح دهید که این عدد از نظر مفهومی چه معنایی دارد و چگونه متغیر مستقل توانسته تغییرات متغیر وابسته را پوشش دهد.
۳. دستکاری ساختگی دادهها برای تایید فرضیات
اگر فرضیهای رد شد، اصلاً نگران نباشید. رد شدن فرضیه به معنی اشتباه بودن کار شما نیست، بلکه یک نتیجه علمی است. دستکاری دادهها علمیترین بخش کار را زیر سوال میبرد و امکان کشف آن در جلسه دفاع بسیار بالا است.
<h2 id="section6" style="font-
سوالات متداول
بهترین نرمافزار برای انجام تحلیل آماری فصل چهارم چیست؟
انتخاب نرمافزار به نوع دادهها و رشته تحصیلی بستگی دارد؛ برای تحلیلهای توصیفی و رگرسیون عمومی SPSS، برای مدلسازی معادلات ساختاری SmartPLS یا AMOS، و برای پژوهشهای کیفی MAXQDA مناسبترین گزینهها هستند.
اگر فرضیههای پژوهش در فصل چهارم تایید نشوند چه باید کرد؟
رد شدن فرضیهها به معنی شکست تحقیق نیست و نباید دادهها را دستکاری کرد. شما باید علت علمی تایید نشدن فرضیه و ارتباط آن با واقعیتهای موجود را بر اساس دادهها تحلیل و گزارش کنید.
آیا میتوان خروجی مستقیم نرمافزار آماری را در فصل چهارم قرار داد؟
خیر، کپیپیست کردن خروجی خام نرمافزارها یکی از دلایل اصلی رد شدن فصل چهارم است. تمام جدولها باید به فارسی ترجمه، سادهسازی و بر اساس استاندارد نگارشی دانشگاه تنظیم شوند.
فصل چهارم پایان نامه شامل چه بخشهای اصلی است؟
این فصل معمولاً شامل پالایش دادهها، آمار توصیفی (نمودارها و مشخصات نمونه)، بررسی پیشفرضهای آزمونها، آمار استنباطی (آزمون فرضیهها) و جدول خلاصه یافتهها است.
تفاوت فصل چهارم در پژوهشهای کمی و کیفی چیست؟
در پژوهشهای کمی تمرکز بر اعداد، آزمونهای آماری و مدلسازی است؛ اما در پژوهشهای کیفی، دادهها شامل متن مصاحبهها بوده و بر کدگذاری، استخراج تمها و شبکهسازی مفاهیم تمرکز دارد.